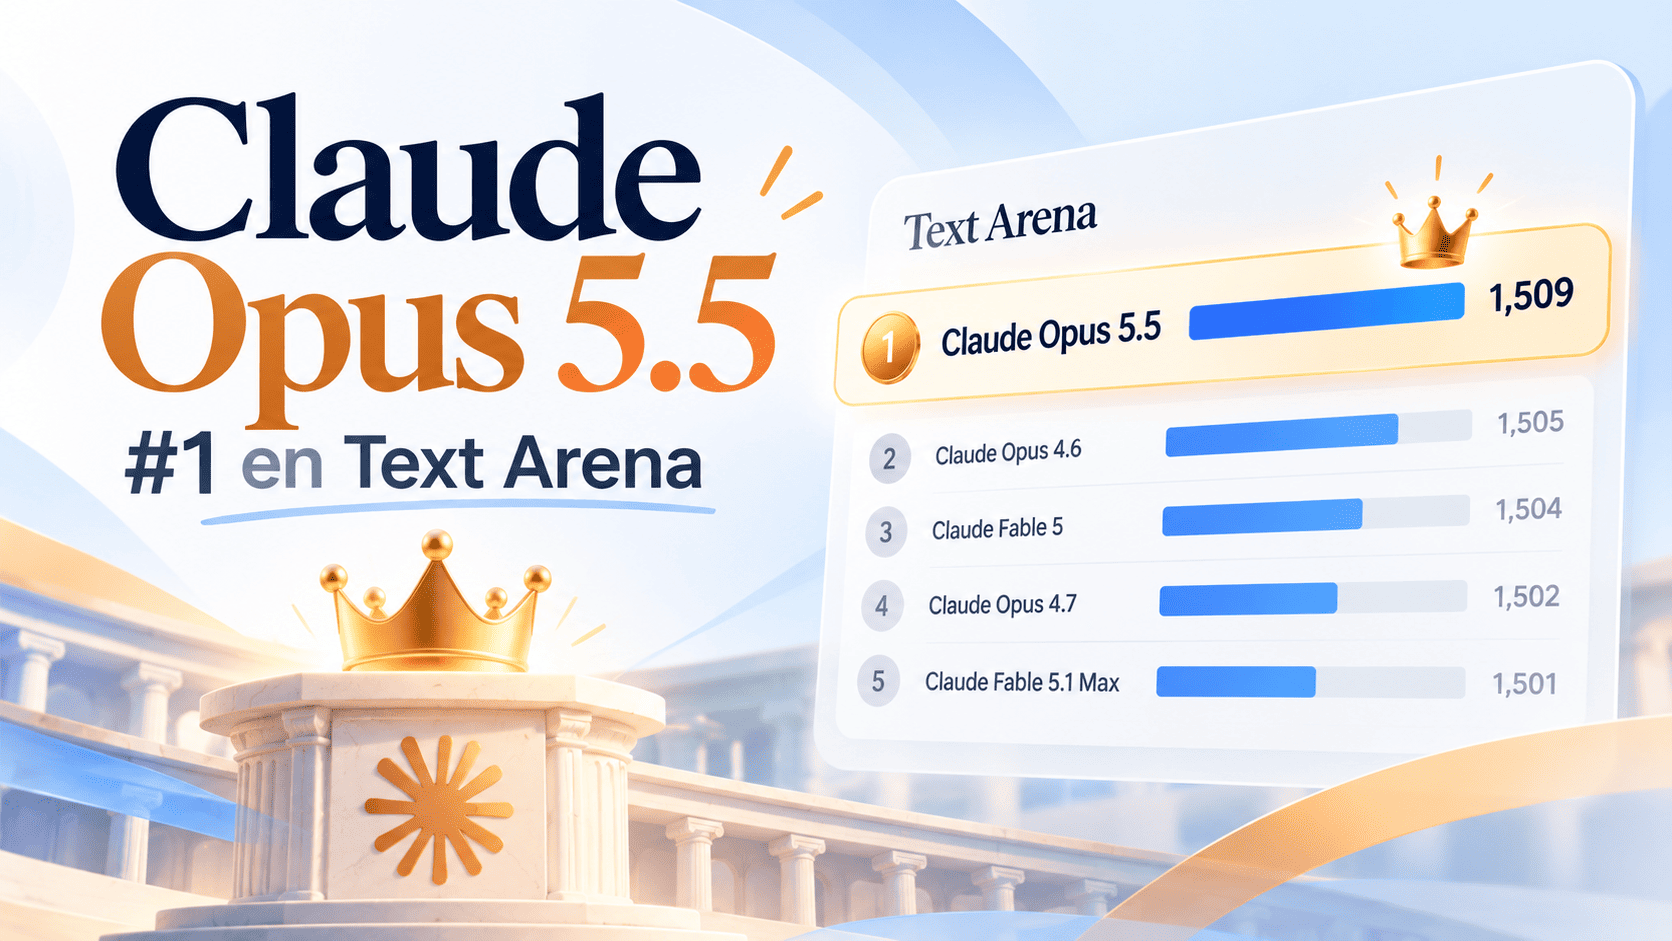
Revisado el 27 de septiembre de 2026. La tabla del 25 de septiembre registra Opus 5.5 High con 1509 ±12, 2307 votos y rango 1–10. La clasificación cambia con el tiempo.
El titular está confirmado: Opus 5.5 High encabeza la referencia revisada de Text Arena. El ranking ayuda a seleccionar candidatos; el negocio debe comprobar idiomas, documentos, herramientas y decisiones que afectan a clientes.
¿Qué muestran los 1509 puntos?
La tabla del 25 de septiembre registra Opus 5.5 High con 1509 ±12 y 2307 votos. Opus 4.6 High tiene 1505 ±3. Opus 5 High, 1491: una diferencia de 18 puntos en esa referencia.
Son puntuaciones relativas, no porcentajes de aciertos. Los intervalos se superponen y la nueva entrada tiene menos votos. Cuatro puntos no prueban superioridad en cualquier tarea.
Arena mide preferencias humanas
Arena compara respuestas mediante elecciones de personas. Su metodología explica ranking e incertidumbre. La tabla muestra incertidumbre de puntuación y rango de posiciones; el revisado para Opus 5.5 High es 1–10.
Lee categoría y ajustes además del puesto. Comparaciones de texto, benchmarks de código y agentes con herramientas responden preguntas distintas. Usa la evidencia según lo que mide.
La presentación influye en la preferencia
Arena estudia longitud y Markdown al controlar estilo. Reporta cambios de clasificación tras ajustar esos factores. La presentación puede influir junto con el contenido.
Separa legibilidad y exactitud. Señala afirmaciones sin respaldo, requisitos ausentes e instrucciones inútiles antes de valorar lo convincente que suena una respuesta.
Lanzamiento y ranking son fuentes distintas
Anthropic anunció Opus 5.5 el 22 de septiembre de 2026. Describe disponibilidad y mejoras en programación, uso de ordenador y otras tareas. Son afirmaciones del proveedor; Arena utiliza otra metodología.
Registra modelo y nivel de razonamiento. Aquí analizamos “Opus 5.5 High”, sin afirmar ajustes o resultados idénticos en cualquier producto que lo utilice.
Evalúa el proceso real de tu negocio
Prepara ejemplos: consultas en inglés y español, una solicitud incompleta, extracción de documento y un caso donde convenga preguntar. Utiliza datos sintéticos o protegidos.
Define éxito primero. Clasificar en CRM exige campos válidos y escalado prudente. Programar requiere cambios revisados. Un borrador de soporte necesita exactitud en el idioma del cliente.
- Modelo, ajustes y versión del prompt.
- Exactitud e información ausente.
- Idioma e instrucciones.
- Latencia, coste y reintentos.
- Revisión humana y recuperación.
Pasa de candidatos a una automatización fiable
Compara resultados completos y coste operativo. Empieza por una tarea de bajo impacto, como preparar un borrador revisable, antes de permitir acciones sobre clientes.
En Make o n8n, la IA es una parte del proceso. Valida salida, conserva contexto, define reintentos y asigna excepciones. El valor está en el flujo fiable, no en una insignia de primer puesto.
Preguntas frecuentes
¿1509 significa un 95 % de exactitud?
No. Es una puntuación relativa, no porcentaje de aciertos para tu tarea.
¿El primer puesto es permanente?
No. Indicamos fecha e incertidumbre. Votos, filtros y nuevos modelos modifican la tabla.
¿Debemos cambiar todas las automatizaciones?
El ranking no basta. Compara tareas, coste, latencia y manejo de fallos antes de sustituir una integración.
Fuentes y revisión editorial
Fuentes primarias consultadas. Las recomendaciones prácticas son análisis editorial de Meuveryone. No afirmamos afiliación con estas empresas.
Usa Arena para elegir candidatos y formular preguntas. Decide después de evaluar el proceso que tu negocio realmente ejecutará.
Explorar el servicio relacionado ↗